エンジニアリング
表情のバインドをどう実現したか
VirmiiがAIで生成した表情画像、顔への投影、カメラトラッキングを組み合わせ、シェイプキーの自動制作をせずにまばたきや口の動きを実現するまで。
生成したアバターは頭を動かせるのに、顔は動かない。最初は、トラッキングと表情の名前をつなげれば解決するように見えました。しかし必要だったのは、人がまばたきをしたり口を開けたりしたときに、実際に表示できる表情でした。
前の記事では、形状の異なる生成モデルに対して、顔のシェイプキーを自動で作る難しさを説明しました。その課題が解消されたわけではありません。今回は別の方法を実装しました。目や口の表情画像を生成して顔に配置し、カメラから得た動きに合わせて表示する画像を選びます。
3Dモデルの動きを保ちながら、顔の表情を画像で表現する仕組みです。顔全体が変形するフェイシャルリグを自動制作するものではありません。
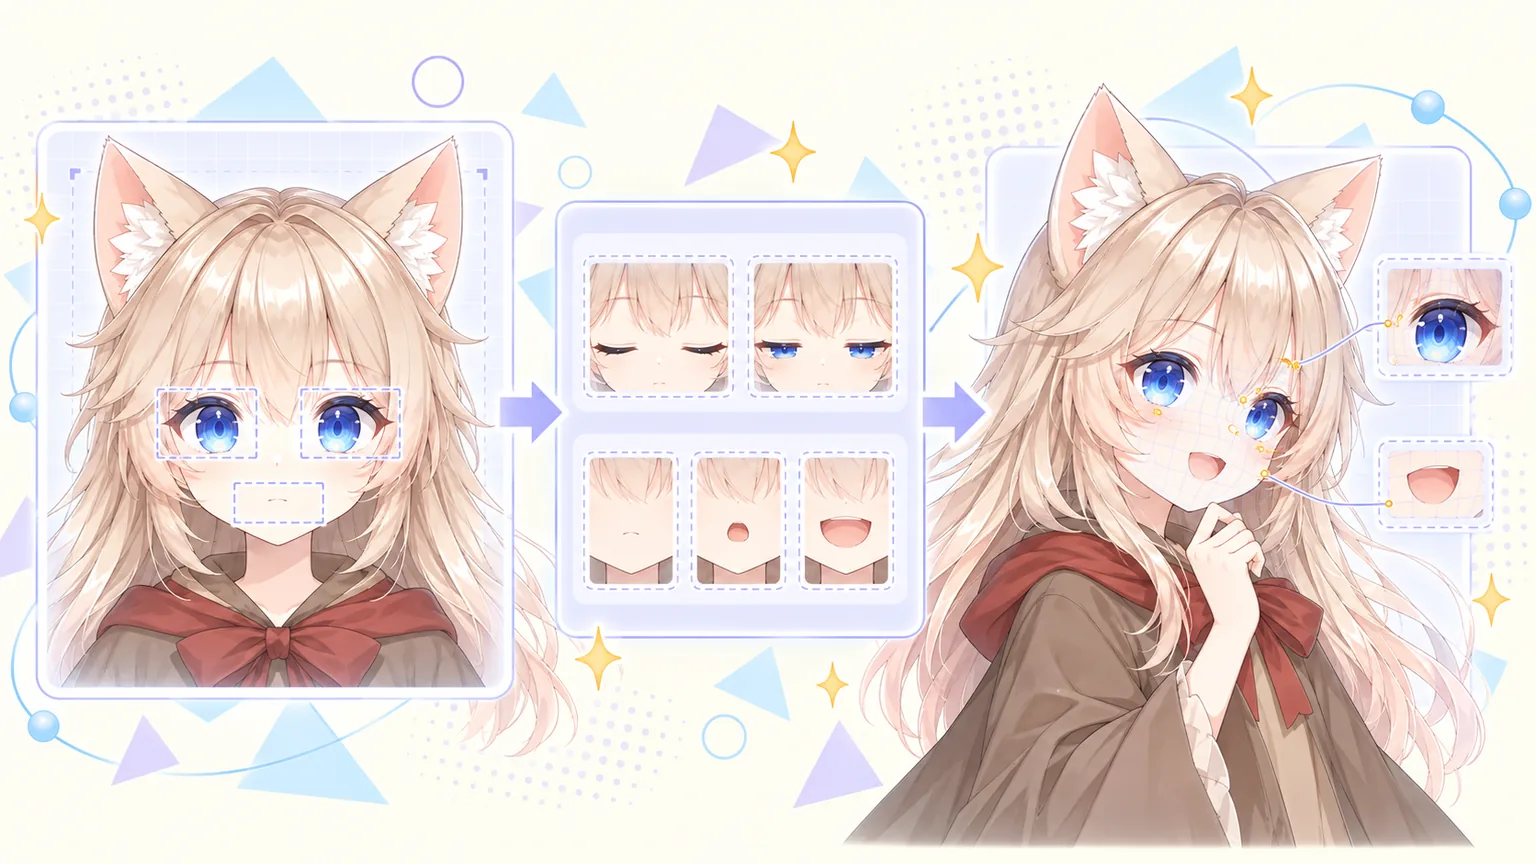
仕組みのイメージ図です。顔の領域を特定し、表情画像を生成して、動く顔へ投影します。実際の製品画面ではありません。
完成したモデルの顔を参照する
参照画像には、元のキャラクターイラストではなく、完成した3Dモデルを使います。Virmiiが一時的にニュートラルな姿勢へ戻し、正面から1024×1024の画像をレンダリングした後、元の姿勢に戻します。
生成モデルの顔が元のイラストと完全に一致するとは限りません。表情を合わせる相手は、実際に画面に表示されるモデルです。この方法なら、テキストから作ったモデルにも同じ手順を使えます。元のイラストは必要ありません。
この参照画像をGeminiへ送ります。使うのはアバターのレンダリング画像であり、所有者のWebカメラ画像ではありません。
表情画像を作る前に、目と口の位置を決める
最初に、画面から見た左目、右目、口の3つの領域を特定します。境界は画像の左上を原点とする、0から1までの座標で表します。
当初はプロンプトでJSONを要求し、返却形式にもJSONを指定していました。しかし、それだけではフィールド名や座標の型までは制約できません。本番環境では、返された領域データが検証を通らず、表情画像の生成を開始する前に失敗したケースがありました。
そこで、更新した実装ではJSON Schemaも送るようにしました。成功時は明示的なステータスと3つの領域を返し、各領域を0から1までの数字4個に制限します。正面の顔として認識できない場合は、status: "not_frontal"とregions: nullを返す形式に分けました。
ただし、形式が正しくても位置が正しいとは限りません。領域の大きさ、左右の目の順序、口が目より下にあること、広げた描画領域が重なったり画像の外へ出たりしないことも検証します。
13枚を生成して、繰り返し使う
生成する画像は次の組み合わせです。
| 表情画像 | 枚数 |
|---|---|
| 閉じた目と半閉じの目 | 2 |
| 穏やかな笑顔 | 1 |
| 5種類の母音の口型 | 5 |
| それぞれ小さく開いた口型 | 5 |
| 合計 | 13 |
ニュートラルな表情には元の顔を使うため、そのための画像を追加生成する必要はありません。
各画像は同じ参照画像から編集します。顔の位置、構図、照明、髪などを維持し、必要な部分だけを変えるよう指示します。特に、小さい口と大きい口で、口内や舌の色をそろえることが重要でした。小さい口はピンク、大きい口はほぼ黒では、トラッキングが正しくても切り替わりが不自然に見えます。
生成はバックグラウンドのバッチリクエストで行い、リクエストごとに専用のコールバックURLを用意します。画像のリクエストを先に送ってから完了を待つため、13回の待ち時間を直列に積み重ねる構成にはしていません。処理には最大24時間程度かかる場合があり、その間はページを閉じられます。
コールバックを受け取ると、サーバーは署名とバッチの対応を確認します。その後Googleから結果を取得し、画像を検証してR2へ保存します。再生に使えるのは、全画像がそろってからです。
表情を顔の動きに追従させる
最初の実験では、モデルを正面に固定していました。位置合わせは簡単になりますが、アバターの動きが乏しく感じられました。頭や体のトラッキングは残したいと考えました。
現在は、ニュートラルな姿勢で参照画像をモデルへ投影し、その座標をメッシュに記録します。スキニングによって、この座標も顔と一緒に動きます。再生時は、左目、右目、口のマスクで表情画像を表示する場所を分けます。
この分離により、両目が閉じた1枚の画像を片目のまばたきにも使えます。片目だけを閉じるときは、その目の領域にだけ画像を適用し、顔全体を置き換えません。
投影には別の問題もありました。口の画像が顎の奥の面にまで届き、正面では見えなかった白っぽい部分が、頭を傾けると首や襟の近くに現れることがありました。
再生側の修正では、頭部ボーンのウェイトで描画対象を限定し、ニュートラルな正面視点の深度画像で顔の後ろに隠れている面を除外しています。これにより無関係な面への投影を抑えます。ただし、モデルの形状やボーンのウェイトには依存します。あらゆる顔を正確に切り分ける仕組みではありません。
画像を混ぜるより、中間の表情を選ぶ
最初は表情画像同士を徐々に混ぜて切り替えていました。しかし、目や口の輪郭が2つ同時に見え、まぶたや口に残像が出ることがありました。
現在は、その瞬間に1つの不透明な表情を選びます。まばたきは半閉じ、閉じ目、再び開いた状態へと進みます。周囲の顔になじませるためにぼかすのは、画像の領域の縁だけです。
口にはもう一つ修正が必要でした。当初、小さい口型は大きい口型へ移る前の短い中間段階にすぎませんでした。そのため、少しだけ口を開けたままでも、最終的には最大の口型になってしまいました。
現在はトラッキングの強さに応じて選びます。小さな動きでは小さい口型を維持し、大きな動きで大きい口型を使います。大きい口へ切り替える基準と、小さい口へ戻す基準を分け、境界付近で細かく切り替わるのを防ぎます。口の感度も調整できます。
左右の目も独立した状態を持ち、まばたきの感度と開眼時の基準値を反映してから閉じるかを判断します。固定のしきい値では反応しにくい、小さな片目のまばたきに必要な調整です。
これらは段階的な表情画像です。丁寧に作られたシェイプキーのように、顔の形状を連続的に変形させるものではありません。
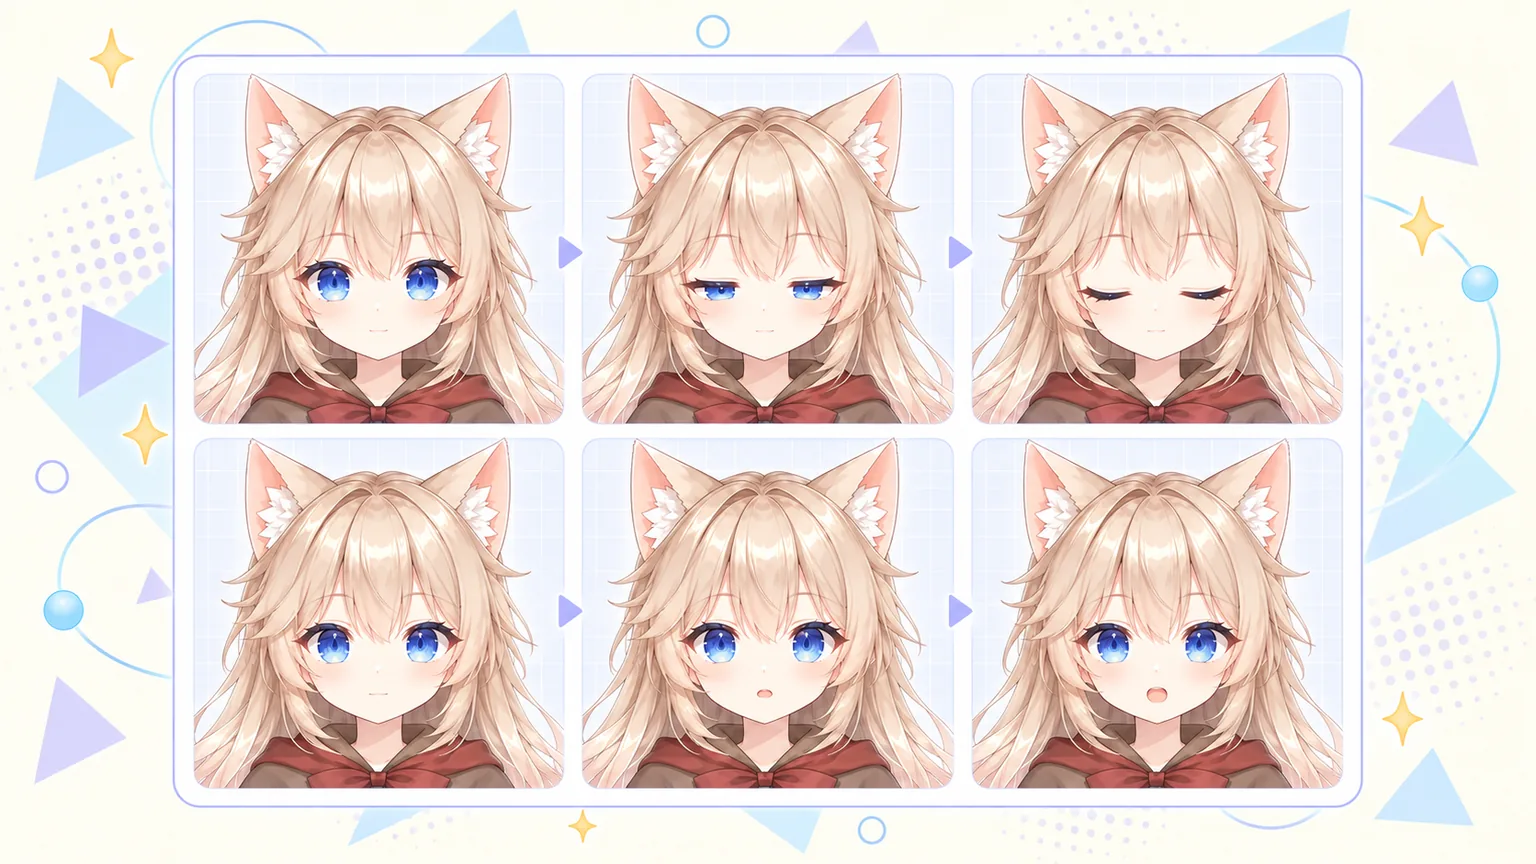
段階的な表情を示すイメージ図です。再生時は2つの顔を重ねて混ぜず、目や口の動きに応じた画像を選びます。
失敗しても、完成した画像は捨てない
保存に成功した画像は、モデルのバージョンに紐づけて記録します。失敗したタスクを再試行するときは、それらを保持し、未完成の画像だけを生成します。既存のバッチ結果の取得や保存が中断した場合は、まずその結果を再取得し、すぐに新しい生成をやり直さない仕組みです。
一度成功した画像は、そのモデルバージョンで確定します。アプリには成功画像をリセットして作り直す入口を設けず、サーバーも記録済みの画像キーの置き換えを拒否します。
ただし、保存の成功は見た目の品質を保証しません。有効な画像でも、口の形や色が不自然な場合はあります。また、送信タイムアウトでプロバイダーがリクエストを受理したか不明な場合、費用が発生していないと保証することもできません。
現在の対応範囲
この仕組みは、テキストまたは画像からVirmiiで生成したモデルに接続しています。ユーザーがアップロードしたVRMは、引き続きファイルに含まれる表情バインドを使います。アップロードだけで不足する表情が追加されるわけではありません。
正面からはっきり顔が見える必要があります。非人型の顔、隠れた目や口、特殊な頭部比率、凹凸の強い顔、大きな首振りでは、検出や位置合わせが不安定になる場合があります。
表情画像はVRMとは別に保存され、Virmiiのモデルプレビュー、Live Studio、OBS表示で再生されます。モデルをダウンロードしても、この再生機能が埋め込まれたり、他のアプリ用のシェイプキーが追加されたりすることはありません。
今回作ったのは、顔のメッシュを自動制作する問題を先に解かなくても、対応する生成アバターに見える表情を与える方法です。3Dのリグが体を動かし、画像が顔の表情を作り、トラッキングが使うタイミングを決めます。
操作手順はAI表情生成ガイドをご覧ください。
AI表情生成は未契約なら1セット20クレジットです。Creator・Proはプランに含まれる月次回数を優先し、超過分は1セット20クレジットです。失敗しても初回の費用は保持され、不足・失敗した画像だけをモデルのバージョンごとに最大2回まで無料で再試行できます。2回使うと、それ以上の再試行はできません。クレジット、プランの生成回数、モデルの再試行回数は追加消費しません。各プランの月次回数は料金ページで確認できます。